致知|大模型智力长期追踪榜单
写于 编辑于
平时高频使用各种大模型写代码、跑 Agent,最头疼的就是怎么挑模型——毕竟现在很多公开评测基准都被厂商 “刷榜(背题)” 刷得失真了,纸面分数很高,实际用起来却经常翻车。
这里分享一个我平时常看的第三方评测站:
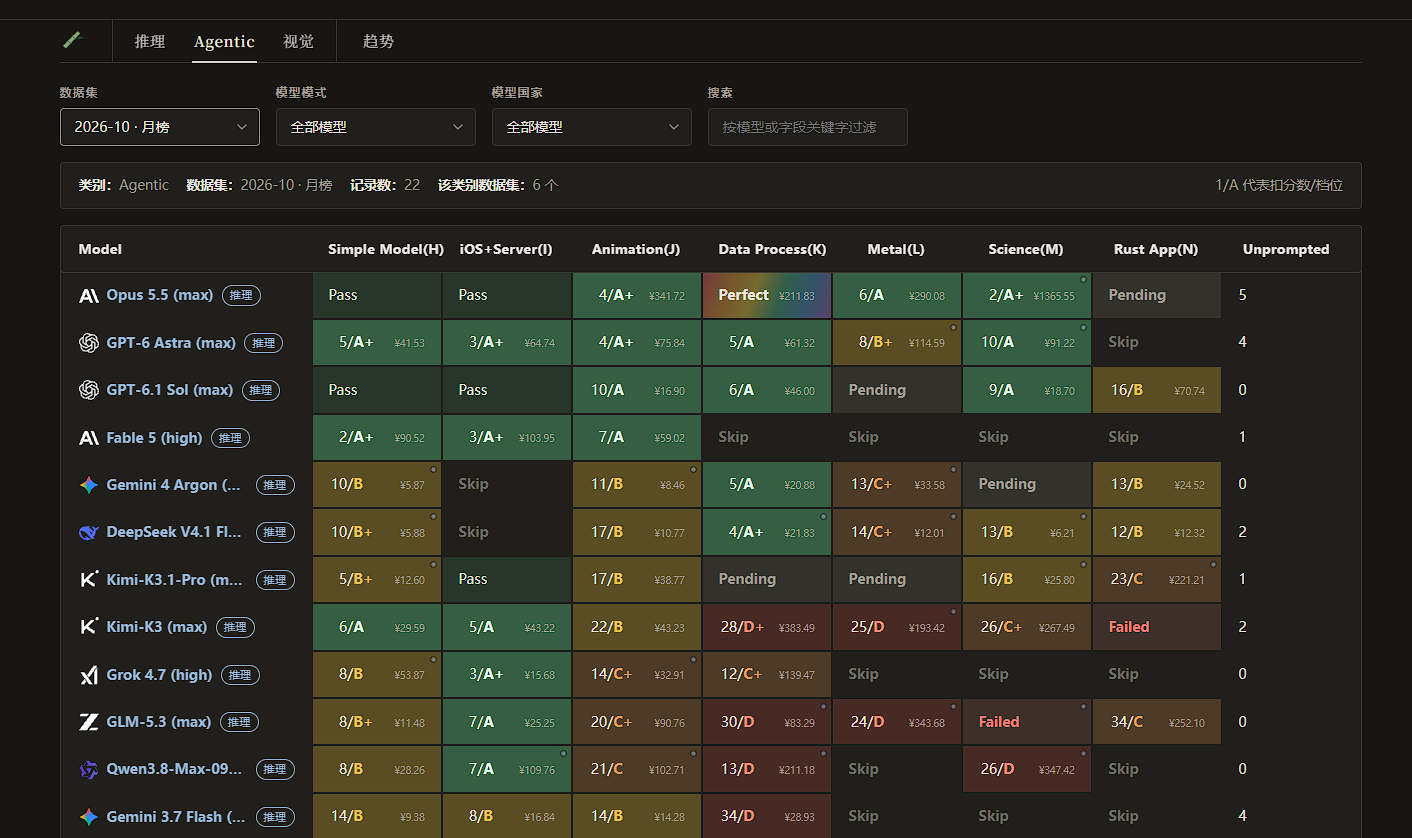
致知|大模型智力长期追踪榜单(由开发者 llm2014 维护)。
相比于大厂发通稿常用的公开跑分,这个榜单有几个非常接地气的亮点:
作者维护了一套不公开的私有测试集(涵盖日志分析、规则推导、代码编写、空间折叠等接近真实人类直觉与工程场景的题目),并且每月滚动更新,最大程度挤掉了模型死记硬背的水分。
从 2024 年至今按月归档,清晰划分了逻辑、编程与视觉三大板块,还能按“快/慢思考(推理模式)”或国家地区进行筛选。
平时纠结该给哪个模型充 API、或者想看最新模型有没有 “降智” 时,去翻一下它的月榜非常有参考价值。
留下几句话
还没有评论,写下第一句话吧。